
Lakehouse nhỏ với Parquet và DuckDB
11 phút đọc13 phần
Một câu hỏi đếm tưởng đơn giản chạm đúng ranh giới giữa OLTP và OLAP. Bài này đi từ Parquet và phân vùng thư mục tới CDC và DuckDB nhúng, cùng những gì OpenVie thực sự làm.
Trong bài này
- Câu hỏi vận hành tưởng đơn giản: đếm văn bản đã duyệt theo workspace
- Vì sao không nên chạy OLAP trên database giao dịch
- Parquet: lưu theo cột kèm metadata (figure)
- Row group, column chunk và page
- Chỉ đọc phần cần: cắt cột và đẩy bộ lọc xuống tệp
- Phân vùng theo thư mục: tenant, năm, tháng
- Trỏ DuckDB vào tệp Parquet (code block)
- CDC: phần biến database thành hồ dữ liệu
- Vì sao ghi phải bất đồng bộ và theo lô
- Object storage tự lưu trữ vẫn dùng được cách này
- Phả hệ và kiểm định chất lượng dữ liệu
- Sao lưu, phục hồi và ranh giới vận hành
- Danh sách kiểm tra khi thiết kế
Câu hỏi vận hành tưởng đơn giản: đếm văn bản đã duyệt theo workspace
Ai đó trong nhóm vận hành hỏi một câu ngắn: tháng này mỗi workspace có bao nhiêu văn bản đã duyệt? Không cần mô hình ngôn ngữ, không cần truy hồi — chỉ cần đếm. Nhưng khi trả lời, bạn nhận ra đây là một bài toán dữ liệu.
Dữ liệu phục vụ ứng dụng và dữ liệu phục vụ phân tích có hình dạng khác nhau. Câu hỏi này chạm vào bốn điểm cùng lúc:
- Phạm vi tenant: mỗi workspace thuộc một tenant, và kết quả không được rò rỉ giữa các tenant.
- Khối lượng: số văn bản tăng theo thời gian, còn câu trả lời chỉ là một bảng nhỏ theo tháng.
- Tần suất: câu hỏi được hỏi lại mỗi tuần, mỗi tháng, cho nhiều workspace.
- Nguồn: trạng thái duyệt nằm trong dữ liệu nghiệp vụ, và bạn muốn đọc nó mà không làm chậm đường ghi của ứng dụng.
Vì sao không nên chạy OLAP trên database giao dịch
PostgreSQL mà OpenVie dùng cho giao dịch tối ưu cho điều ngược lại: đọc ghi từng hàng, độ trễ thấp. Một truy vấn đếm theo tháng quét gần hết bảng lớn là điều nó không được thiết kế để làm thường xuyên.
- Truy vấn quét toàn bảng chiếm CPU và I/O dành cho yêu cầu người dùng.
- Khóa và bộ nhớ đệm bị chia sẻ giữa hai kiểu tải khác nhau.
- Mỗi chỉ số phân tích mới thêm một truy vấn nặng vào cùng một cỗ máy.
- Bạn khó mở rộng phần phân tích mà không mở rộng luôn phần giao dịch.
Cách tách phổ biến là sao chép dữ liệu sang nơi tối ưu cho việc đọc. Truyền thống thì đó là một kho dữ liệu; cách nhẹ hơn là để dữ liệu nằm trong tệp và đọc trực tiếp từ tệp.
Parquet: lưu theo cột kèm metadata (figure)
Parquet là định dạng tệp hướng cột: lưu dữ liệu theo cột, kèm metadata theo từng nhóm cột. Hệ quả rất rõ — một truy vấn chỉ chạm vài cột không phải đọc phần còn lại của tệp.
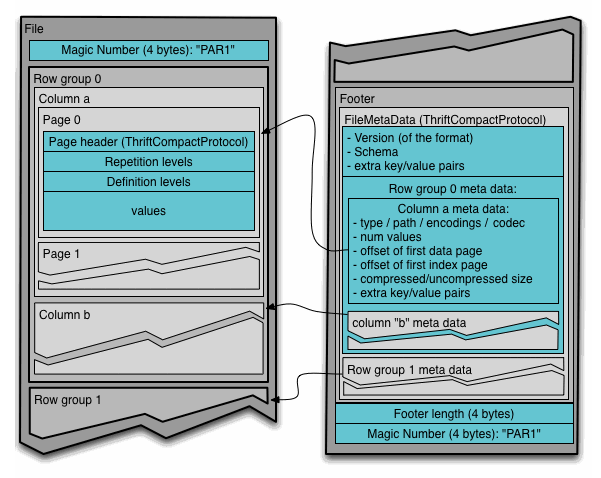
Bố cục tệp Parquet theo tài liệu định dạng chính thức: tệp → row group → column chunk → page, với footer giữ metadata.
Ảnh: Apache Parquet (apache/parquet-format) · Apache License 2.0
Điều này khớp câu hỏi ban đầu: bạn cần workspace, tháng và trạng thái duyệt — ba cột. DuckDB đọc và ghi Parquet trực tiếp, không cần nạp trước vào một database khác, nên bạn trỏ thẳng vào tệp, chi tiết ở hướng dẫn Parquet của DuckDB.
Row group, column chunk và page
Theo tài liệu định dạng chính thức, một tệp Parquet có cấu trúc phân cấp rõ ràng. Hiểu nó giải thích vì sao cắt cột và đẩy bộ lọc lại hiệu quả đến vậy.
- Một tệp gồm nhiều row group, thường vài chục nghìn hàng mỗi nhóm.
- Mỗi row group chia thành các column chunk, mỗi chunk giữ dữ liệu của một cột.
- Mỗi column chunk là một dãy page liên tiếp — đơn vị nhỏ nhất mà tầng đọc làm việc cùng.
Vì dữ liệu một cột nằm liền nhau trong column chunk, đọc vài cột chỉ là một tập đọc nhỏ. Vì mỗi row group có thống kê riêng, bộ lọc loại cả row group mà không chạm dữ liệu bên trong — cả hai cùng phục vụ mục tiêu đọc ít nhất có thể.
Chỉ đọc phần cần: cắt cột và đẩy bộ lọc xuống tệp
Hai kỹ thuật làm nên phần lớn tốc độ đọc Parquet. Cắt cột chỉ đọc những cột truy vấn thực sự dùng. Đẩy bộ lọc xuống áp điều kiện ngay ở tầng tệp để bỏ qua dữ liệu không khớp.
- Cắt cột: tầng đọc chỉ mở đúng các column chunk cần thiết thay vì toàn bộ hàng.
- Đẩy bộ lọc: dựa vào thống kê row group, một số row group bị bỏ qua hoàn toàn.
- Kết hợp cả hai: lượng dữ liệu phải giải mã giảm mạnh trước khi tính toán.
Phía người viết SQL, bạn chỉ cần chọn đúng cột, viết WHERE cụ thể và để engine lo phần còn lại. Điều bạn chủ động là sắp dữ liệu cho bộ lọc phổ biến khớp với cấu trúc tệp — đó là lúc phân vùng bước vào.
Phân vùng theo thư mục: tenant, năm, tháng
Phân vùng là chia dữ liệu thành nhiều tệp theo giá trị của một cột, rồi đặt vào thư mục có tên phản ánh giá trị đó. DuckDB hỗ trợ phân vùng kiểu Hive theo đường dẫn, nên tenant=acme/year=2026/month=10 trở thành một phần của bộ lọc.
Với OpenVie, ba cột phân vùng đã rõ: tenant, năm, tháng. Truy vấn một tenant trong một tháng chỉ mở đúng thư mục đó. Phân vùng theo tenant biến ranh giới tenant thành ranh giới thư mục, nhất quán với phần còn lại: Qdrant và Kuzu luôn lọc theo tenant, quyền do vai trò ORG_OWNER, WORKSPACE_ADMIN, MEMBER quyết định.
Phân vùng không làm truy vấn nhanh lên một cách thần kỳ. Nó chỉ làm cho tập tệp phải mở nhỏ đi — và điều đó thường là yếu tố quyết định.
Đổi lại, quá nhiều thư mục nhỏ khiến mỗi truy vấn phải mở nhiều tệp và tốn chi phí metadata. Chọn khóa phân vùng là quyết định thiết kế, không phải mặc định. Cách DuckDB ánh xạ tên thư mục thành cột nằm trong tài liệu phân vùng Hive.
Trỏ DuckDB vào tệp Parquet (code block)
DuckDB cho truy vấn Parquet bằng một hàm đọc ngay trong SQL. Bạn dùng mẫu đường dẫn có ký tự đại diện để gom nhiều tệp trong một thư mục phân vùng, và cột phân vùng được nhận diện từ tên thư mục.
SELECT workspace_id, month, count(*) AS approved_documentsFROM read_parquet('s3://lakehouse/tenant=acme/year=2026/month=10/*.parquet')WHERE approval_status = 'approved'GROUP BY workspace_id, monthORDER BY workspace_id;Truy vấn chạm đúng ba cột, lọc trên một cột, gom theo workspace cùng tháng. Không có bước nạp nào trước: DuckDB đọc thẳng tệp Parquet, dù trên đĩa hay object storage.
CDC: phần biến database thành hồ dữ liệu
Đọc tệp là nửa sau của câu chuyện. Nửa trước là đưa dữ liệu từ database giao dịch tới hồ dưới dạng Parquet — việc của CDC, change data capture.
Trong OpenVie, thay đổi từ database đi qua RabbitMQ rồi được ghi thành Parquet nén Snappy trên SeaweedFS S3. Ứng dụng vẫn ghi PostgreSQL như thường, còn một luồng riêng mang thay đổi ra hồ.
- Thay đổi được phát ra khi dữ liệu nghiệp vụ thay đổi.
- Thông điệp đi qua RabbitMQ, tách tốc độ ghi của ứng dụng khỏi tốc độ của hồ.
- Bộ ghi nhận thông điệp và tạo tệp Parquet nén Snappy.
- Tệp được đặt vào thư mục phân vùng tenant, năm, tháng trên SeaweedFS S3.
Các bộ dữ liệu tách theo lĩnh vực: chat, audit, document và workflow. Kết quả là một hồ nhỏ đủ dùng: dữ liệu ở Parquet chuẩn, DuckDB nhúng chạy SQL phân tích trên đó mà không gây tải lên PostgreSQL.
Vì sao ghi phải bất đồng bộ và theo lô
Nếu mỗi thay đổi tạo ngay một tệp Parquet nhỏ, bạn sớm có hàng nghìn tệp tí hon. Mỗi tệp mang chi phí metadata và mở tệp mà mọi truy vấn về sau phải trả.
Vì thế đường ghi được thiết kế bất đồng bộ và theo lô: thay đổi gom lại rồi ghi thành tệp kích thước hợp lý, và ứng dụng không bị buộc phải chờ hồ dữ liệu.
- Bất đồng bộ: ứng dụng không chặn theo tốc độ của hồ.
- Theo lô: nhiều thay đổi nhỏ gộp thành ít tệp lớn hơn.
- Nén Snappy: giảm dung lượng lưu trữ với chi phí giải mã chấp nhận được.
- Phân vùng: giữ số tệp trong mỗi thư mục ở mức hợp lý.
Đây cũng là mô hình DuckLake mô tả: ghi nhanh bằng nhiều lô nhỏ rồi nén gộp ở nền. Nó thừa nhận ghi nhanh và đọc hiệu quả có nhu cầu khác nhau — nền tảng tốt dung hòa cả hai. Chi tiết ở bài kiến trúc DuckLake của MotherDuck.
Object storage tự lưu trữ vẫn dùng được cách này
Một hiểu lầm hay gặp là lakehouse chỉ hợp với cloud. Điều đó không đúng: Parquet là định dạng tệp, object storage là giao diện đọc ghi, và bạn tự chạy được cả hai.
- Parquet chuẩn hoạt động với mọi hệ thống đọc được định dạng này, kể cả tệp trên S3, Azure Blob, GCS, R2 hay Tigris.
- SeaweedFS S3 trong OpenVie là object storage tự lưu trữ, tương thích giao diện S3.
- DuckDB nhúng chạy trong tiến trình, không cần cluster riêng, và đọc trực tiếp tệp.
- Bạn giữ quyền kiểm soát vị trí dữ liệu, khóa truy cập và vòng đời tệp.
Đổi lại, bạn tự lo hạ tầng: cấu hình truy cập, phân quyền, sao lưu, giám sát. DuckLake cũng theo tinh thần đó: mang blob storage riêng, dữ liệu ở Parquet chuẩn, catalog lo phần quản lý.
Phả hệ và kiểm định chất lượng dữ liệu
Khi dữ liệu chảy qua nhiều bước, câu hỏi đổi từ con số đúng chưa thành con số này đến từ đâu. Phả hệ dữ liệu — lineage DAG — trả lời bằng cách ghi lại các bước biến đổi và quan hệ phụ thuộc.
- Lineage DAG: mỗi bộ dữ liệu biết nó sinh ra từ đâu và đi qua những bước nào.
- Khung kiểm định chất lượng: các kiểm tra chạy như một phần của đường ống, không phải việc thủ công.
- Kiểm tra điển hình: hàng thiếu, hàng trùng, giá trị ngoài miền hợp lệ, phân vùng rỗng bất thường.
- Kết quả kiểm định phải nhìn thấy được, nếu không nó chỉ là bước chạy mà không ai đọc.
Sao lưu, phục hồi và ranh giới vận hành
OpenVie cung cấp script vận hành sao lưu và phục hồi có kiểm chứng SHA-256 (scripts/ops/backup.sh, restore.sh), kèm một buổi diễn tập phục hồi thảm họa. Lịch chạy thuộc về người vận hành: sản phẩm cho bạn công cụ, nó không quyết định thay bạn chạy lúc nào.
- Đặt tần suất sao lưu theo tốc độ thay đổi dữ liệu và mức mất mát chấp nhận được.
- Kiểm chứng bản sao lưu bằng SHA-256 trước khi tin vào nó.
- Chạy diễn tập phục hồi định kỳ, không chỉ khi có sự cố.
- Ghi lại ai chịu trách nhiệm cho từng bước và bằng chứng mỗi lần chạy.
Ranh giới cũng cần rõ: tầng phân tích là bản sao dùng để đọc, không thay thế database giao dịch.
Danh sách kiểm tra khi thiết kế
- Chọn khóa phân vùng khớp với câu hỏi phổ biến nhất, ví dụ tenant, năm, tháng.
- Giữ tệp ở kích thước hợp lý; tránh biến hồ thành hàng nghìn tệp nhỏ.
- Chỉ định rõ bộ dữ liệu nào dùng nén Snappy và vì sao.
- Viết SQL chỉ chọn cột cần thiết để cắt cột phát huy tác dụng.
- Đẩy bộ lọc xuống bằng điều kiện
WHEREcụ thể và đúng kiểu. - Tách bộ dữ liệu theo lĩnh vực — chat, audit, document, workflow — khi hình dạng và tần suất hỏi khác nhau.
- Thiết kế đường ghi bất đồng bộ và theo lô ngay từ đầu.
- Thêm kiểm tra chất lượng dữ liệu vào đường ống, kèm cảnh báo khi bước kiểm tra thất bại.
- Ghi lại phả hệ để có thể lần ngược nguồn của mỗi con số.
- Đặt lịch sao lưu và diễn tập phục hồi, ghi rõ người chịu trách nhiệm.
Với OpenVie, câu trả lời là một hồ Parquet phân vùng, ghi qua CDC, đọc bằng DuckDB nhúng, tuân theo cùng ranh giới tenant như phần còn lại của hệ thống. Lõi headless: toàn bộ năng lực đi qua HTTP JSON tại /api/v1/**, ứng dụng web chỉ là một client tham chiếu. Bạn có thể giữ cách này hoặc thay — miễn là hiểu cái giá của nó.