
Stack tiếng Việt cục bộ: BGE-M3 và VyLinh 3B trong OpenVie
11 phút đọc13 phần
Một stack RAG chạy tại chỗ cần hai mô hình làm hai việc khác nhau: một embedder để truy hồi, một mô hình sinh để viết câu trả lời. OpenVie mặc định dùng BGE-M3 và VyLinh 3B qua Ollama, và bài này giải thích cả lựa chọn lẫn giới hạn của nó.
Trong bài này
- Hai bài toán khác nhau, hai mô hình khác nhau — vì sao truy hồi và sinh văn bản phải tách
- BGE-M3: ba chế độ truy hồi trong một lần mã hoá
- Vì sao vector 1024 chiều với 8192 token ngữ cảnh lại quan trọng với văn bản hành chính
- VyLinh 3B: một mô hình nhỏ cho tiếng Việt
- Giới hạn mà chính model card thừa nhận
- Nạp mô hình vào Ollama
- Mặc định cục bộ, và ranh giới khi trỏ ra endpoint ngoài
- Hấp thụ tài liệu: sáu định dạng, 20 MB, chống trùng lặp SHA-256
- OCR và ASR là tuỳ chọn, không phải mặc định
- Reranker tuỳ chọn và chính sách fail-open
- “Hơn 100 ngôn ngữ” thực chất nghĩa là gì (đo trên MIRACL/MKQA)
- Cái giá của việc chạy tại chỗ: bộ nhớ, thời gian nạp, độ trễ
- Danh sách kiểm tra trước khi triển khai
Một hệ thống RAG trả lời hai câu hỏi khác nhau: lấy đúng đoạn văn bản nào, và viết câu trả lời từ những đoạn đó như thế nào. OpenVie tách hai câu hỏi này thành hai mô hình, và mặc định cả hai chạy cục bộ.
Hai bài toán khác nhau, hai mô hình khác nhau — vì sao truy hồi và sinh văn bản phải tách
Chặng truy hồi trả về các đoạn văn bản liên quan. Chặng sinh biến chúng thành câu trả lời mạch lạc. Hai chặng tối ưu cho hai mục tiêu khác nhau: mô hình embedding phải xếp hàng nghìn đoạn theo mức liên quan, còn mô hình sinh phải diễn đạt một câu trả lời đọc được.
Dùng một mô hình sinh cho cả hai việc là sai hướng. Mô hình sinh chấm điểm liên quan kém ổn định và tốn kém hơn, còn mô hình embedding thì không viết được câu nào. Tách ra còn giúp bạn thay một nửa mà không đụng nửa kia: đổi embedder khi dữ liệu hoặc ngôn ngữ thay đổi, giữ nguyên phần sinh.
OpenVie chọn cả hai mô hình chạy cục bộ: bge-m3 cho embedding và vylinh (~3B tham số) cho chat, nạp qua Ollama. Đây là mặc định, không phải ràng buộc — ranh giới khi trỏ ra ngoài được nói rõ ở phần sau.
- Chặng truy hồi biến truy vấn và tài liệu thành vector, so khớp rồi xếp hạng.
- Chặng sinh đọc các đoạn đã truy hồi và viết câu trả lời.
- Hai chặng có tham số, tốc độ và kiểu sai khác nhau, nên tách là lựa chọn đúng.
BGE-M3: ba chế độ truy hồi trong một lần mã hoá
BGE-M3 gộp ba chế độ truy hồi vào một encoder: dense (một vector 1024 chiều cho toàn bộ văn bản), multi-vector (vector cho từng token) và sparse (trọng số từ khoá). Cả ba ra từ cùng một lần mã hoá, nên bạn không phải nuôi ba mô hình riêng.
Model card của BGE-M3 khuyến nghị một pipeline rõ ràng: chạy hybrid retrieval trước, rồi re-ranking sau. Nghĩa là embedder lo phần thu hẹp phạm vi, còn reranker lo phần tinh chỉnh thứ hạng cuối cùng.
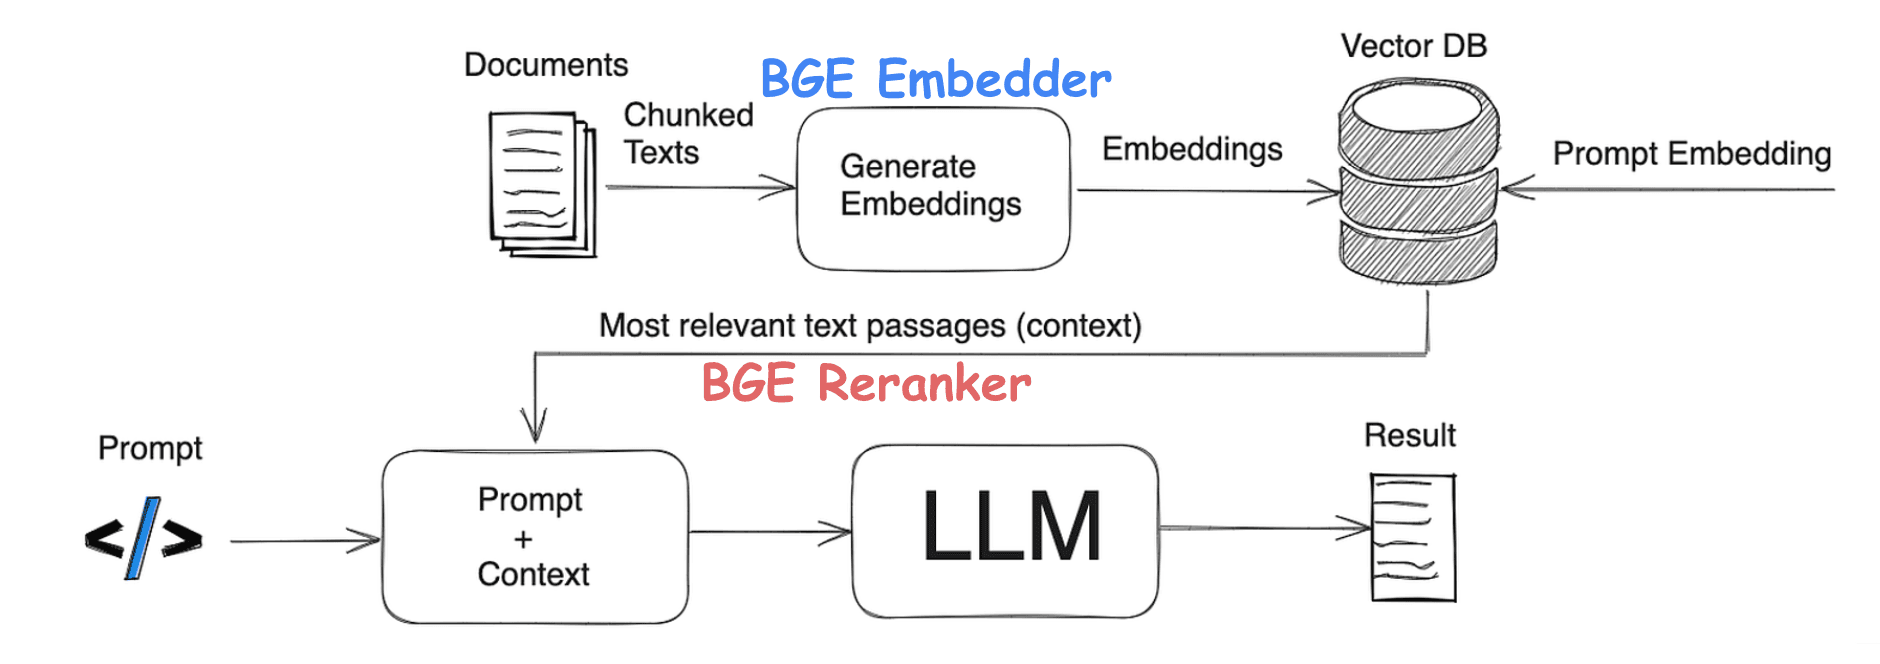
Sơ đồ của FlagEmbedding thể hiện đúng cách OpenVie tách vai: embedder và reranker lo truy hồi, LLM lo sinh văn bản. Hai vai đầu chạy cục bộ trong cùng một stack; phần sinh là một mô hình chat riêng.
BGE-M3 dùng giấy phép MIT, hỗ trợ hơn 100 ngôn ngữ và nhận tới 8192 token mỗi lần mã hoá. Ba đặc điểm đó định hình phần còn lại của bài.
Vì sao vector 1024 chiều với 8192 token ngữ cảnh lại quan trọng với văn bản hành chính
Văn bản hành chính hiếm khi ngắn. Một quyết định có thể dài hàng chục trang, với điều khoản này tham chiếu điều khoản kia, phụ lục nằm cách phần thân vài nghìn token. Cắt nhỏ theo cửa sổ trượt làm mất chính những mối liên hệ đó.
Hai tham số của BGE-M3 giải quyết trực tiếp vấn đề này. Vector 1024 chiều cho mô hình đủ dung lượng để mã hoá sắc thái thay vì chỉ từ khoá; ngữ cảnh 8192 token cho phép một đoạn dài giữ nguyên mạch nghĩa trong một lần mã hoá.
Ngữ cảnh dài không phải tình cờ. BGE-M3 dựng trên xlm-roberta-large, mở rộng max_length lên 8192 rồi pretrain tiếp bằng RetroMAE. Đó là lý do mô hình chịu được văn bản dài mà không vỡ ngữ nghĩa.
Với bạn, điều này nghĩa là chiến lược chunking có thể rộng tay hơn: giữ một điều khoản trọn vẹn thay vì cắt giữa câu rồi hy vọng mô hình ghép lại được.
VyLinh 3B: một mô hình nhỏ cho tiếng Việt
VyLinh 3B là mô hình sinh trong stack. Nó dựng trên Qwen2.5-3B, có ngữ cảnh 32K token và được tối ưu cho tiếng Việt.
Quá trình huấn luyện đi qua nhiều bước: EvolKit sinh 20K câu hỏi khó, SFT trên dữ liệu đó, hợp nhất mô hình, 6 epoch DPO lặp trên ORPO-Mix-40K, rồi hợp nhất lần cuối với Qwen2.5-3B-Instruct. Nhóm huấn luyện đánh giá trên tập con tiếng Việt của m-ArenaHard, với Claude 3.5 Sonnet làm giám khảo.
Vì sao chọn mô hình ~3B? Vì nó vừa đủ chạy trên máy cá nhân hoặc một máy chủ nhỏ. Đổi lại, bạn không nhận một mô hình cạnh tranh với các mô hình lớn ở mọi tác vụ; nó đủ tốt cho việc trả lời dựa trên tài liệu đã truy hồi.
Giới hạn mà chính model card thừa nhận
- Nội dung đặc thù văn hoá: mô hình vẫn có thể bịa.
- Trọng tâm chính là tiếng Việt; các ngôn ngữ khác không được tối ưu.
- Miền kỹ thuật chuyên sâu: có thể không phải điểm mạnh của mô hình.
Nạp mô hình vào Ollama
Cài đặt gói gọn trong ba lệnh Ollama: kéo embedder, kéo GGUF của VyLinh ở mức lượng tử hoá Q4_K_M, rồi đặt bí danh ngắn vylinh để phần còn lại của cấu hình trỏ tới.
ollama pull bge-m3ollama pull hf.co/QuantFactory/Arcee-VyLinh-GGUF:Q4_K_Mollama cp hf.co/QuantFactory/Arcee-VyLinh-GGUF:Q4_K_M vylinhLượng tử hoá Q4_K_M giảm dung lượng và bộ nhớ so với trọng số đầy đủ, đổi lại một phần chất lượng. Đây là lựa chọn thực dụng cho máy không có GPU lớn; nếu bạn dư VRAM, hãy thử mức cao hơn và tự đo trên dữ liệu của mình.
Lệnh cp đặt tên ngắn ổn định cho mô hình vừa kéo, để cấu hình OpenVie không phải nhúng cả đường dẫn dài của kho HuggingFace.
Mặc định cục bộ, và ranh giới khi trỏ ra endpoint ngoài
Mặc định của OpenVie là mô hình cục bộ qua Ollama. Trong cấu hình đó, nội dung tài liệu của tenant không rời khỏi hạ tầng của bạn.
Bạn có quyền trỏ ra một endpoint tương thích OpenAI bên ngoài. Đó là lựa chọn của người vận hành, và nó có ranh giới rõ: khi trỏ ra ngoài, trích đoạn nội dung tenant vượt qua ranh giới của provider đó.
Một điều cần nói thẳng: mã nguồn trong repo chưa phải bằng chứng của một dịch vụ production. Các tích hợp provider tuỳ chọn và phần gia cố triển khai phải được kiểm chứng trong môi trường của bạn.
OpenVie là phần mềm tự host, ưu tiên tiếng Việt, phát hành theo Apache-2.0. Không có lớp dịch vụ nào đứng giữa bạn và dữ liệu của bạn.
Hấp thụ tài liệu: sáu định dạng, 20 MB, chống trùng lặp SHA-256
Hấp thụ tài liệu chạy bất đồng bộ. OpenVie nhận sáu nhóm định dạng: PDF, DOCX, TXT, MD, HTML, và nhóm bảng tính gồm XLSX với CSV.
Giới hạn mặc định là 20 MB mỗi tệp, và mỗi tệp được băm SHA-256 để chặn trùng lặp. Đăng lại cùng một tài liệu không tạo thêm bản sao trong kho.
Hai cơ chế này giữ kho tri thức sạch. Giới hạn dung lượng chặn một tệp khổng lồ làm nghẽn hàng đợi; hàm băm chặn việc cùng một nội dung được nhúng lại nhiều lần, vốn làm loãng kết quả truy hồi.
Nếu tài liệu vượt 20 MB, hãy tách nhỏ hoặc nén trước khi tải lên. Biết trước giới hạn rẻ hơn nhiều so với việc phát hiện tệp bị bỏ qua giữa hàng đợi.
OCR và ASR là tuỳ chọn, không phải mặc định
OCR và ASR đều tắt theo mặc định. OpenVie coi chúng là tuỳ chọn, không phải đường đi chính của mọi tài liệu.
Khi cần, OCR có hai lựa chọn: Tesseract với gói tiếng Việt và tiếng Anh (vie+eng), hoặc một VLM chạy qua Ollama. ASR dùng faster-whisper hoặc một endpoint tương thích OpenAI.
Bật chúng bằng các biến cấu hình INGESTION_*. Giữ mặc định tắt là có lý: chạy OCR trên mọi tệp vừa tốn thời gian vừa thêm một điểm có thể sai, trong khi phần lớn tài liệu đã có sẵn lớp văn bản.
Reranker tuỳ chọn và chính sách fail-open
Reranker cross-encoder chạy qua TEI là tuỳ chọn trong OpenVie. Khi bật, nó chấm lại thứ hạng của các đoạn mà embedder đã thu hẹp trước đó.
Chính sách khi lỗi là fail-open. Nếu reranker không trả lời, pipeline vẫn dùng kết quả từ bước truy hồi trước đó thay vì dừng toàn bộ luồng hỏi đáp.
Model card của BGE-M3 cũng khuyến nghị đúng thứ tự này: hybrid retrieval trước, re-ranking sau. Reranker là lớp cải thiện thứ hạng, không phải điều kiện bắt buộc để hệ thống chạy.
Fail-open là lựa chọn có đánh đổi: hệ thống chịu được sự cố reranker, nhưng chất lượng thứ hạng tụt trong lúc đó mà không có lỗi rõ ràng. Hãy kiểm tra trạng thái reranker định kỳ thay vì để nó im lặng hỏng.
“Hơn 100 ngôn ngữ” thực chất nghĩa là gì (đo trên MIRACL/MKQA)
Con số hơn 100 ngôn ngữ đến từ các bộ đánh giá đa ngôn ngữ và liên ngôn ngữ mà nhóm BGE dùng để công bố kết quả BGE-M3: MIRACL và MKQA. Họ cũng dùng MLDR, một bộ 13 ngôn ngữ cho truy hồi văn bản dài.
Điểm trung bình qua hơn 100 ngôn ngữ không hứa hẹn chất lượng đồng đều. Một ngôn ngữ có thể mạnh trên MKQA và yếu hơn trên văn bản hành chính dài. Đó là lý do bạn nên đo trên chính dữ liệu của mình.
Với OpenVie, điều này khớp với định hướng thiết kế: mục tiêu là tiếng Việt trước, các ngôn ngữ khác dùng được nhưng không phải điểm tựa.
Cái giá của việc chạy tại chỗ: bộ nhớ, thời gian nạp, độ trễ
Chạy tại chỗ đổi chi phí API thành chi phí phần cứng và thời gian của bạn. Ba điểm cần tính trước khi cam kết.
- Bộ nhớ: trọng số của cả embedder lẫn mô hình chat phải nằm trong RAM hoặc VRAM. Ngữ cảnh 32K của VyLinh càng dài thì phần bộ nhớ dành cho ngữ cảnh càng lớn.
- Thời gian nạp: lần gọi đầu tiên phải đọc mô hình từ đĩa vào bộ nhớ; các lần sau nhanh hơn vì mô hình đã nằm sẵn trong bộ nhớ.
- Độ trễ: mỗi câu trả lời dài tốn thời gian sinh token, và nhiều người dùng cùng lúc chia sẻ một ngân sách tính toán.
Những chi phí này không xuất hiện trên hoá đơn API, nhưng chúng có thật. Máy yếu sẽ thấy rõ nhất ở lần nạp mô hình đầu tiên và khi nhiều truy vấn chạy song song.
Danh sách kiểm tra trước khi triển khai
Trước khi triển khai, hãy đi qua danh sách này theo thứ tự.
- Xác nhận máy đủ bộ nhớ cho cả
bge-m3lẫnvylinhcùng lúc. - Kéo đúng hai mô hình và tạo bí danh
vylinhbằngollama cp. - Quyết định rõ giữ mô hình cục bộ hay trỏ ra endpoint ngoài, và ghi lại lý do.
- Kiểm tra giới hạn 20 MB cùng các định dạng tài liệu bạn thực sự cần hấp thụ.
- Chỉ bật OCR hoặc ASR khi tài liệu thật sự cần, thông qua các biến
INGESTION_*. - Quyết định có bật reranker TEI hay không và chấp nhận chính sách fail-open.
- Đo chất lượng trên dữ liệu của bạn thay vì tin vào điểm số của model card.
- Kiểm chứng tích hợp provider và phần gia cố triển khai trong môi trường của bạn.
Bước cuối là bước dễ bỏ qua nhất. Mã nguồn trong repo không thay thế được một lần chạy thử trên dữ liệu và hạ tầng thật của bạn.