
Truy hồi hybrid: dense, sparse và đồ thị cho tài liệu nội bộ
18 phút đọc15 phần
Truy hồi hybrid không phải là cộng điểm dense với BM25. Bài này đi qua từng quyết định: ba biểu diễn của BGE-M3, RRF, DBSF, lấy thô rồi chấm lại, chunking, đồ thị và viết lại câu hỏi — kèm cái giá của mỗi lựa chọn.
Trong bài này
- Vì sao vector thuần không đủ với tài liệu nội bộ
- Chỗ từ khoá thắng: truy vấn nhiều định danh
- Một encoder, ba biểu diễn (BGE-M3)
- Bằng chứng: chế độ sparse học được so với BM25 (figure)
- Vì sao không cộng trực tiếp điểm dense và BM25
- RRF: hợp nhất bằng thứ hạng, không bằng thang điểm
- RRF có trọng số và DBSF: hai cách khi thứ hạng chưa đủ
- Chọn và tinh chỉnh trọng số mà không tự lừa mình
- Cái giá của hợp nhất: thuế trên từng truy vấn
- Truy hồi nhiều tầng: lấy thô rồi chấm lại
- Chunking quyết định chất lượng bằng chứng
- Đồ thị: khi nào đáng thêm một nhánh
- Viết lại câu hỏi nối tiếp
- OpenVie cài đặt những điều này ở đâu
- Tóm lại
Vì sao vector thuần không đủ với tài liệu nội bộ
Truy hồi dense mã hoá câu hỏi và đoạn văn thành hai điểm gần nhau trong không gian embedding. Cách này mạnh với diễn đạt đồng nghĩa: hỏi cách đổi mật khẩu vẫn tìm được đoạn viết về thay đổi mật khẩu. Nhưng tài liệu nội bộ không chỉ có câu văn tự nhiên.
Tài liệu nội bộ chứa mã lỗi, số hợp đồng, tên viết tắt, ký hiệu phiên bản, mã sản phẩm và tên người. Với những định danh đó, embedding thường thất bại theo cách âm thầm: mã OVK-2291 và OVK-2219 gần như trùng nhau về mặt vector nhưng khác hoàn toàn về ý nghĩa, còn một chuỗi như ERR_403_TENANT có thể không mang ngữ nghĩa nào để bám vào.
- Câu hỏi chứa định danh hiếm: model embedding chưa từng thấy token đó trong huấn luyện, nên vector gần như vô nghĩa.
- Câu hỏi khớp từ hiếm nhưng chính xác: một mã tài liệu, một mã lỗi, một số điều khoản.
- Câu hỏi ngắn, ít ngữ cảnh: dense cần ngữ cảnh để suy ra ý, nhưng người dùng chỉ gõ ba từ.
Bạn không cần bỏ dense. Bạn cần thêm một nhánh biết đếm từ. Đó là toàn bộ lý do truy hồi hybrid tồn tại: hai cách nhìn khác nhau về cùng một kho tài liệu, không phải một cách tốt hơn thay thế cách kia.
Chỗ từ khoá thắng: truy vấn nhiều định danh
Truy hồi từ khoá, điển hình là BM25, chấm điểm dựa trên tần suất từ và độ hiếm của từ trong ngữ liệu. Nó không hiểu ngữ nghĩa, nhưng nó khớp chính xác. Với một câu hỏi toàn định danh, đó chính là thứ bạn muốn.
Hãy hình dung một truy vấn kiểu: lỗi này xuất hiện ở phiên bản nào, mã ticket nào, workspace nào. Trong đó có tên sản phẩm, số phiên bản và mã ticket. Dense có thể trả về các đoạn nói chung về lỗi thời gian chờ, nghe rất hợp lý nhưng sai tài liệu. BM25 chỉ cần thấy đúng chuỗi mã là đã đưa đoạn đúng lên đầu.
- Truy vấn có mã lỗi, mã ticket, mã hợp đồng, số phiên bản: từ khoá thắng rõ rệt.
- Truy vấn diễn đạt lại bằng từ đồng nghĩa, không có từ hiếm: dense thắng.
- Truy vấn trộn cả hai: cần cả hai nhánh, và cần một cách hợp nhất tử tế.
Điểm mấu chốt là tài liệu nội bộ hiếm khi chỉ thuộc một trong hai loại. Một kho vận hành thật luôn có cả văn xuôi lẫn định danh, thường trong cùng một tài liệu. Vì vậy câu hỏi không phải chọn dense hay sparse, mà là ghép chúng mà không phá vỡ thứ hạng của cả hai.
Một encoder, ba biểu diễn (BGE-M3)
BGE-M3 là một encoder đa ngữ tạo ra ba biểu diễn cho cùng một đầu vào. Cùng một lượt chạy model, bạn nhận được ba cách nhìn khác nhau về đoạn văn, thay vì phải vận hành ba model riêng.
- Vector dense: một điểm cho toàn đoạn, phục vụ tìm kiếm ngữ nghĩa gần đúng trên chỉ mục vector.
- Trọng số sparse học được: mỗi token có một trọng số, cho phép khớp từ chính xác kiểu từ khoá nhưng do model học ra thay vì đếm thủ công.
- Vector đa vector kiểu ColBERT: một vector cho mỗi token, dùng khi cần chấm lại chi tiết hơn.
Vì dense và sparse đến từ cùng một encoder, chúng chia sẻ cùng tokenizer và cùng không gian biểu diễn. Điều này giúp việc vận hành đơn giản hơn: một model, một lần suy luận, hai chỉ mục lấy từ cùng một nguồn. Bạn vẫn phải lưu hai chỉ mục — một cho vector, một cho trọng số sparse — nhưng không phải đồng bộ hai pipeline khác nhau.
Bằng chứng: chế độ sparse học được so với BM25 (figure)
Câu hỏi tự nhiên là liệu nhánh sparse học được có thật sự đáng thêm vào hay chỉ là BM25 khoác áo mới. Báo cáo BGE-M3 công bố bảng so sánh trực tiếp giữa BM25 và chế độ sparse của M3 trên ba bộ dữ liệu đa ngữ.
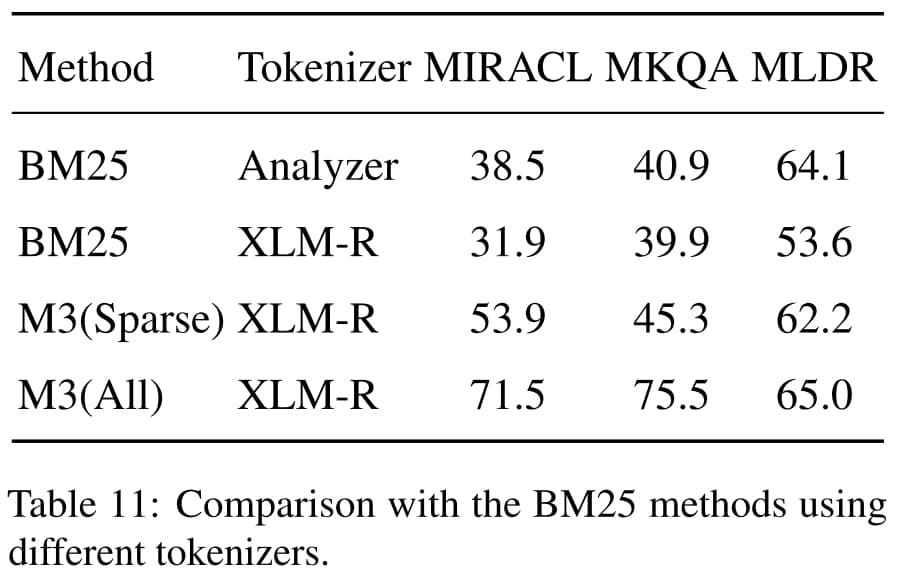
Bảng 11 trong báo cáo BGE-M3. Trên MIRACL và MKQA, M3(Sparse) vượt BM25 dùng tokenizer Analyzer (53.9 và 45.3 so với 38.5 và 40.9); trên MLDR, BM25 vẫn nhích hơn (64.1 so với 62.2). M3(All) — dùng cả ba biểu diễn — thắng mọi cột (71.5 / 75.5 / 65.0).
Đọc bảng theo cột để thấy mẫu hình. Trên MIRACL, M3(Sparse) đạt 53.9 so với 38.5 của BM25 Analyzer và 31.9 của BM25 XLM-R — chênh lệch lớn. Trên MKQA, M3(Sparse) đạt 45.3, vượt cả hai biến thể BM25. Chỉ trên MLDR, BM25 Analyzer mới nhích lên 64.1 so với 62.2 của M3(Sparse).
Bài học không phải là sparse học được luôn thắng. Bài học là nhánh sparse thay thế BM25 có cơ sở, và khi ghép cả ba biểu diễn (M3(All)), kết quả cao nhất ở mọi cột. Nói cách khác, hybrid không phải là phương án dự phòng — nó là cấu hình tốt nhất trong bảng này.
Vì sao không cộng trực tiếp điểm dense và BM25
Phản xạ đầu tiên khi có hai nhánh là cộng điểm của chúng với một hệ số alpha. Cách này phổ biến vì đơn giản, nhưng nó dựa trên một giả định sai: rằng hai thang điểm có thể so sánh trực tiếp.
Điểm cosine bị chặn trong một khoảng cố định. Điểm BM25 thì không bị chặn: nó phụ thuộc độ dài tài liệu, tần suất từ và độ hiếm, nên có thể nhảy từ vài đơn vị lên hàng chục giữa hai truy vấn khác nhau. Khi bạn cộng chúng bằng một hệ số cố định, nhánh nào có biên độ lớn hơn sẽ lấn át nhánh kia — và nhánh lấn át thay đổi theo từng truy vấn.
Cosine bị chặn trong một khoảng, BM25 thì không. Cộng hai thang điểm khác nhau bằng một hệ số alpha tuyến tính là không đáng tin, nhất là khi thang điểm còn đổi theo từng truy vấn.
Tài liệu Qdrant nói thẳng điều này: kết hợp tuyến tính theo alpha giữa điểm dense và BM25 không đáng tin. Vấn đề không nằm ở việc chọn alpha sai, mà ở chỗ một hệ số cố định không thể chuẩn hoá hai phân phối điểm thay đổi liên tục. Đây chính là lý do các phương pháp hợp nhất dựa trên thứ hạng ra đời.
RRF: hợp nhất bằng thứ hạng, không bằng thang điểm
Reciprocal Rank Fusion (RRF) bỏ qua giá trị điểm và chỉ dùng thứ hạng. Mỗi nhánh trả về một danh sách xếp hạng; RRF cộng nghịch đảo thứ hạng của từng tài liệu trên các nhánh để ra điểm cuối.
score(d) = Σ_branches 1 / (k + rank_branch(d)) // Qdrant: k mặc định là 2, đặt lại được// chỉ cần thứ hạng, không cần điểm thôVì chỉ dùng thứ hạng, RRF miễn nhiễm với khác biệt thang điểm. Một tài liệu đứng đầu ở nhánh dense và hạng ba ở nhánh sparse sẽ được đẩy lên, trong khi một tài liệu chỉ xuất hiện ở một nhánh vẫn có điểm nhưng thấp hơn. Hằng số k làm dịu ảnh hưởng của các hạng đầu: k nhỏ khiến top-1 chi phối mạnh hơn, k lớn san phẳng đóng góp giữa các hạng.
Điểm yếu của RRF là nó vứt bỏ thông tin về độ chắc chắn. Hai tài liệu cách nhau rất xa về điểm vẫn có thể chỉ cách nhau một bậc hạng, nên RRF đối xử với chúng gần như nhau. Đó là cái giá của sự ổn định, và cũng là lý do tồn tại các biến thể bên dưới.
RRF có trọng số và DBSF: hai cách khi thứ hạng chưa đủ
Khi bạn có lý do để tin nhánh này hơn nhánh kia, RRF có trọng số cho phép gán hệ số cho từng nhánh trước khi cộng. Điểm cuối là tổng có trọng số của các đóng góp nghịch đảo thứ hạng. Đây vẫn là hợp nhất dựa trên thứ hạng, chỉ khác ở chỗ trọng số thể hiện mức tin cậy.
DBSF (Distribution-Based Score Fusion) đi theo hướng ngược lại: nó dùng điểm thô nhưng chuẩn hoá phân phối điểm của mỗi nhánh theo ba độ lệch chuẩn quanh giá trị trung bình, rồi cộng các điểm đã chuẩn hoá. Nếu mọi điểm trong một nhánh bằng nhau, DBSF trả về 0.5 cho nhánh đó, tránh chia cho phương sai bằng không.
- Có tập đánh giá để tinh chỉnh: dùng weighted RRF.
- Tin vào độ lớn tương đối của điểm thô: dùng DBSF.
- Không có gì để đo và muốn mặc định an toàn: dùng RRF.
Ba hướng dẫn chọn này đến từ tài liệu Qdrant và chúng nhất quán với trực giác: hợp nhất theo thứ hạng là mặc định vì nó không giả định gì về thang điểm; DBSF chỉ nên dùng khi bạn thật sự tin điểm thô; còn weighted RRF chỉ đáng dùng khi bạn có bằng chứng để đặt trọng số.
Chọn và tinh chỉnh trọng số mà không tự lừa mình
Trọng số trong weighted RRF là một tham số, và mọi tham số đều có thể bị tinh chỉnh quá mức. Nếu bạn đo chất lượng trên chính tập mà bạn dùng để tinh trọng số, kết quả sẽ đẹp hơn thực tế. Đó không phải là cải thiện, đó là tự lừa mình.
- Chia tập đánh giá thành hai nửa tách biệt.
- Tinh chỉnh trọng số trên một nửa.
- Đo kết quả trên nửa còn lại, nửa chưa từng được dùng để tinh.
- Chỉ chấp nhận cấu hình nếu nó thắng trên nửa kiểm tra.
Ngoài ra, trọng số không phải là hằng số vĩnh viễn. Tài liệu Qdrant khuyến nghị tinh lại khi bạn đổi retriever, đổi cách chunking, hoặc khi ngữ liệu trôi — tài liệu mới vào làm phân phối điểm dịch chuyển. Một trọng số tốt cho tháng này có thể lệch vào tháng sau.
Cách thực dụng là bắt đầu từ RRF không trọng số, đo, rồi chỉ thêm trọng số khi dữ liệu cho thấy một nhánh thật sự mạnh hơn trên loại truy vấn của bạn. Đừng bắt đầu bằng việc tinh chỉnh ba tham số cùng lúc trên một tập nhỏ.
Cái giá của hợp nhất: thuế trên từng truy vấn
Hợp nhất không miễn phí. Một phân tích có tên The Fusion Tax đo trên bảy bộ BEIR và ba hàm hợp nhất cho thấy ngay cả phương pháp tốt nhất — nội suy điểm có trọng số theo hướng dense — vẫn xếp tài liệu liên quan thấp hơn nhánh tốt hơn của chính nó trên 13–48% truy vấn, và thấp hơn cả dense-only trên 8–21% truy vấn.
Vài quan sát quan trọng đi kèm. RRF chịu thuế cao hơn khi một nhánh mạnh hơn hẳn nhánh kia, vì trung bình hoá kéo nhánh mạnh xuống. Tổn thất chủ yếu là hiệu ứng xếp hạng chứ không phải mất mát thu hồi: tài liệu liên quan vẫn nằm trong tập kết quả, chỉ bị tụt hạng. Nó hay xảy ra nhất ở truy vấn mà chỉ một nhánh đủ sức phủ.
Có một cách hạn chế một phần: dùng cross-encoder chấm lại. Nhưng cross-encoder chỉ thu hồi được một phần tổn thất, và chỉ ở nơi chính nó đáng tin. Nếu tài liệu đúng đã bị đẩy ra khỏi tập ứng viên, cross-encoder không có gì để chấm.
Truy hồi nhiều tầng: lấy thô rồi chấm lại
Một cách kiểm soát chi phí và chất lượng là tách thu hồi thành hai tầng: tầng đầu lấy ứng viên rẻ, tầng sau chấm lại đắt nhưng chính xác hơn. Qdrant hỗ trợ mô hình này bằng prefetch lồng nhau: một truy vấn con chạy trước, kết quả của nó làm đầu vào cho truy vấn chính.
// tầng 1: lấy ứng viên bằng vector rút gọn (byte/MRL)// tầng 2: chấm lại bằng vector đầy đủ// hoặc multi-vector ColBERT // vector chỉ dùng để chấm lại có thể tắt HNSW:// m = 0Ý tưởng là vector rút gọn (quantization theo byte, hoặc cắt chiều theo MRL) đủ tốt để lọc thô nhanh, nhưng không đủ chính xác để xếp hạng cuối. Bạn lấy một tập ứng viên rộng bằng vector rút gọn, rồi chấm lại tập nhỏ đó bằng vector đầy đủ hoặc bằng multi-vector ColBERT — vốn chấm từng token và chính xác hơn nhưng đắt hơn.
Một chi tiết vận hành: vector chỉ dùng để chấm lại không cần chỉ mục đồ thị tìm kiếm gần đúng. Tắt HNSW bằng m=0 cho những vector đó giúp tiết kiệm bộ nhớ vì chúng không bao giờ tham gia tìm kiếm thô. Đây là tối ưu nhỏ nhưng đáng làm khi chấm lại bằng vector đầy đủ trên toàn bộ ứng viên.
Chunking quyết định chất lượng bằng chứng
Mọi nhánh truy hồi chỉ tốt bằng đơn vị văn bản mà nó trả về. Nếu đoạn trích không chứa câu trả lời, không hàm xếp hạng nào cứu được bạn. Chunking là quyết định nằm trước cả dense lẫn sparse, và nó quyết định chất lượng bằng chứng cho mọi thứ phía sau.
- Overlap không cho lợi ích đo được mà còn tăng chi phí chỉ mục — trên Natural Questions với SPLADE và Mistral-8B, phần chồng lấn không cải thiện chất lượng đủ để biện minh.
- Chunk theo câu là phương án hiệu quả chi phí nhất, ngang với chunk ngữ nghĩa tới khoảng 5k token.
- Có một vách ngữ cảnh: vượt khoảng 2.5k token thì chất lượng giảm.
- Ngữ cảnh tối ưu phụ thuộc mục tiêu: chất lượng ngữ nghĩa đạt đỉnh ở ngữ cảnh nhỏ, còn khớp chính xác cần ngữ cảnh lớn hơn.
Kết quả này khá tiện cho vận hành: chunk theo câu là điểm khởi đầu rẻ và hợp lý, thay vì phải xây một bộ tách ngữ nghĩa phức tạp. Nhưng hãy để ý vách 2.5k token — nó giải thích vì sao nhồi thêm ngữ cảnh vào mỗi chunk thường phản tác dụng. Và vì mục tiêu khác nhau cần kích thước khác nhau, đừng giả định một cấu hình chunk phục vụ tốt cả hỏi đáp ngữ nghĩa lẫn tra cứu chính xác.
Đồ thị: khi nào đáng thêm một nhánh
Đồ thị tri thức là nhánh thứ ba, và cũng là nhánh dễ bị thêm vào một cách lãng phí nhất. Bằng chứng từ GraphRAG-Bench cho thấy đồ thị không phải là bước tiến phổ quát.
Ở câu hỏi tra cứu sự kiện đơn giản, RAG cơ bản ngang hoặc tốt hơn GraphRAG. Ưu thế của đồ thị chỉ rõ lên khi câu hỏi phức tạp dần: suy luận nhiều bước, tổng hợp ngữ cảnh phân tán, và sinh nội dung mới cần nối các mảnh thông tin nằm rải rác.
- Trên bộ dữ liệu tiểu thuyết (văn bản dài), nhóm câu hỏi phức tạp đạt recall bằng chứng 87.9–90.9% với một triển khai đồ thị.
- Chi phí token tăng mạnh: biến thể dùng tóm tắt cộng đồng đẩy prompt lên hàng chục nghìn token trở lên.
- Biến thể gọn hơn — không dùng tóm tắt cộng đồng — giữ prompt quanh 10^3 token.
Cách đọc đúng là: đồ thị là một công cụ có điều kiện. Nếu người dùng của bạn chủ yếu hỏi tra cứu sự kiện, thêm đồ thị chỉ tốn tiền. Nếu họ hỏi câu hỏi nhiều bước trải trên nhiều tài liệu, đồ thị có thể đáng giá — miễn là bạn chấp nhận mức tiêu thụ token cao hơn nhiều lần và chọn được biến thể đủ gọn.
Viết lại câu hỏi nối tiếp
Trong hội thoại, câu hỏi hiếm khi đứng một mình. Người dùng hỏi về một tài liệu, rồi câu sau chỉ nói còn phần bảo mật thì sao. Nếu bạn đưa nguyên câu đó vào chỉ mục, dense lẫn sparse đều không có gì để bám vào: câu thiếu chủ ngữ và thiếu định danh.
Viết lại câu hỏi nối tiếp là bước biến câu rút gọn thành truy vấn độc lập bằng cách kéo ngữ cảnh từ các lượt trước. Sau khi viết lại, câu trở thành một truy vấn đầy đủ, và cả hai nhánh đều có cơ hội trả về tài liệu đúng. Đây là một thành phần chuẩn của pipeline hybrid nhiều lượt, không chỉ là mẹo giao diện.
- Giữ các lượt trước làm ngữ cảnh.
- Viết lại câu hỏi hiện tại thành truy vấn tự đứng được.
- Chạy truy vấn đã viết lại qua cả nhánh dense lẫn sparse.
- Hợp nhất kết quả và chấm lại.
Bằng chứng từ SemEval-2026 Task 8 củng cố điều này: một pipeline hybrid không cần huấn luyện, kết hợp dense và sparse với làm sạch ngữ liệu, viết lại câu hỏi trong hội thoại và reranking, là một cấu hình hợp lý cho truy hồi nhiều lượt. Không có bước nào trong đó cần huấn luyện lại model.
OpenVie cài đặt những điều này ở đâu
OpenVie là nền tảng RAG tự host, ưu tiên tiếng Việt, phát hành theo Apache-2.0. Những quyết định phía trên không nằm rải rác trong tài liệu — chúng ánh xạ vào các module cụ thể của hệ thống.
- M4 — truy hồi: hybrid dense + sparse + đồ thị, có viết lại câu hỏi nối tiếp và dung hợp thứ hạng RRF.
- M24 — embedding: model mặc định chạy cục bộ qua Ollama, với
bge-m3cho embedding; trỏ ra endpoint tương thích OpenAI ngoài là lựa chọn của người vận hành. - M8 — chấm lại: reranker cross-encoder (TEI) là tùy chọn và fail-open khi lỗi, nên thiếu nó không làm sập luồng truy hồi.
- M9 — tenancy: Qdrant và Kuzu luôn lọc theo tenant, nên nhánh vector, nhánh đồ thị và cả nhánh sparse đều nằm trong cùng một ranh giới dữ liệu.
- M2 — trích dẫn: nguồn chỉ hiển thị sau khi kiểm tra quyền truy cập và phản hồi cuối được lưu; bản nháp không có thẻ nguồn.
Hai lựa chọn thiết kế đáng chú ý. Thứ nhất, M8 cho phép reranker fail-open: nếu dịch vụ TEI chết, truy hồi vẫn trả về kết quả đã hợp nhất thay vì lỗi. Thứ hai, M24 đặt model cục bộ làm mặc định, nên chi phí trả cho mỗi truy vấn gồm một lần suy luận encoder và các lượt chấm lại, không phải hoá đơn API bên ngoài.
Lưu ý về phạm vi: mã nguồn trong repo không phải bằng chứng của một dịch vụ production, và việc gia cố triển khai phải được kiểm chứng trong môi trường của bạn. Các con số benchmark trong bài thuộc về tài liệu gốc, không phải đo lường của OpenVie trên ngữ liệu của bạn.
Tóm lại
Truy hồi hybrid là chuỗi quyết định có cái giá rõ ràng, không phải một nút bật tắt. Mỗi nhánh thêm vào mang lại độ phủ và mang theo chi phí lẫn rủi ro xếp hạng.
- Dense và sparse phủ hai loại truy vấn khác nhau; từ khoá thắng khi truy vấn chứa định danh.
- Đừng cộng điểm thô bằng alpha tuyến tính — thang điểm không so sánh được.
- RRF hợp nhất bằng thứ hạng; weighted RRF và DBSF là lựa chọn khi thứ hạng chưa đủ.
- Hợp nhất có thuế: ngay phương pháp tốt nhất cũng tụt hạng trên 13–48% truy vấn của 7 bộ BEIR.
- Reranking, chunking theo câu và viết lại câu hỏi là những đòn bẩy rẻ hơn thêm nhánh.
- Đồ thị chỉ đáng thêm khi câu hỏi phức tạp; nếu không nó chỉ đốt token.
Nếu bạn chỉ nhớ một điều: hãy đo trên tập tách biệt, chọn mặc định an toàn là RRF, và chỉ thêm độ phức tạp khi dữ liệu của bạn — chứ không phải một benchmark — nói rằng nó đáng.
Nguồn tham khảo
- The Fusion Tax: A Diagnostic Analysis of When Hybrid Retrieval Hurts — arXiv:2610.30612
- When to use Graphs in RAG (GraphRAG-Bench) — arXiv:2506.05690
- A Systematic Analysis of Chunking Strategies for Reliable Question Answering — arXiv:2601.14123
- Hybrid and Multi-Stage Queries — Qdrant documentation
- BAAI/bge-m3 — model card (HuggingFace)
- Hệ thống hybrid nhiều lượt, không cần huấn luyện — SemEval-2026 Task 8