
Từ chối khi thiếu bằng chứng: trôi chảy không có nghĩa là đúng
11 phút đọc13 phần
Abstention — chủ động từ chối trả lời khi không có bằng chứng — là một hành vi phải thiết kế, không phải một câu dặn thêm vào prompt. Bài này đi qua bằng chứng công khai và chỉ ra một hệ thống RAG cần xây gì thay cho lời dặn đó.
Trong bài này
- Vì sao câu trả lời trôi chảy nhưng sai lại tệ hơn không biết
- Thiếu bằng chứng và bằng chứng sai là hai vấn đề khác nhau
- Con số: mô hình nhỏ vẫn trả lời trước ngữ cảnh bị làm sai
- Vì sao dặn mô hình hãy im lặng không đủ
- Trích dẫn cũng có thể bị bịa
- Groundedness không phải truth
- Đo chất lượng trích dẫn: ba chiều và một con số khó chịu
- Ngữ cảnh dài hơn không tự động sửa được (Lost in the Middle)
- Bốn thứ phải xây thay cho một lời dặn
- Thiết kế phép đo: tách thiếu và sai
- OpenVie cài đặt những điều này ở đâu
- Ranh giới: cái gì hệ thống không hứa
- Tóm lại
Vì sao câu trả lời trôi chảy nhưng sai lại tệ hơn không biết
Một câu trả lời sai nhưng trôi chảy gây thiệt hại nhiều hơn một câu nói thẳng rằng hệ thống không biết. Khi hệ thống báo thiếu thông tin, bạn biết phải kiểm tra chỗ khác. Khi nó viết một đoạn văn tự tin, kèm trích dẫn, bạn có xu hướng tin và dừng lại — và cái sai đi thẳng vào quyết định.
Abstention là một hành vi phải thiết kế, không phải một câu dặn thêm vào prompt. Phần còn lại của bài đi qua bằng chứng công khai để chỉ ra vì sao lời dặn 'hãy từ chối' là không đủ.
Thiếu bằng chứng và bằng chứng sai là hai vấn đề khác nhau
Hai tình huống này thường bị gộp thành một, nhưng khác nhau về bản chất. Thiếu bằng chứng nghĩa là bộ truy hồi không mang về đoạn nào liên quan. Bằng chứng sai nghĩa là có đoạn liên quan, nhưng đoạn đó ủng hộ một câu trả lời không đúng.
- Thiếu: bạn cần một bước kiểm tra đủ hay không đủ trước khi sinh câu trả lời.
- Sai: bạn cần kiểm tra xem ngữ cảnh có mâu thuẫn với tri thức đáng tin không — khó hơn nhiều, vì đoạn văn bị làm sai trông hoàn toàn hợp lệ.
- Kết hợp: ngữ cảnh vừa thiếu vừa lẫn đoạn sai; hệ thống phải tách được hai tín hiệu này trước khi quyết định im lặng hay trả lời.
Con số: mô hình nhỏ vẫn trả lời trước ngữ cảnh bị làm sai
Bài GRAB-RAG kiểm cùng một bộ câu hỏi dưới bốn điều kiện ngữ cảnh: supportive (ủng hộ đáp án đúng), degraded (thiếu thông tin), missing (không có đoạn liên quan), và misleading (một đoạn vàng bị sửa để ủng hộ một đáp án sai rồi đặt lẫn vào các đoạn được truy hồi).
- 5 chính sách từ chối khác nhau được thử trên cùng bộ đề.
- 3 mô hình nhỏ đóng băng, kích thước từ 3,8B đến 8B.
- 2 bộ hỏi đáp: Natural Questions và HotpotQA.
Các mô hình từ chối khá đáng tin khi bằng chứng thiếu. Nhưng khi bằng chứng sai, dù đã được dặn phải từ chối, chúng vẫn trả lời 41,6% số câu. Trong số đó, 63% lặp lại nguyên văn thực thể sai đã bị cài.
Chain-of-thought gần như không thêm lợi ích. Một bộ kiểm tra xung đột phía generator kéo tỉ lệ xuống 13,3% nhưng vứt bỏ nhiều câu trả lời đúng. Một verifier NLI lấy lại độ phủ nhưng thất bại khi ký ức tham số của mô hình đồng ý với đoạn sai.
Vì sao dặn mô hình hãy im lặng không đủ
Lý do thất bại nằm trong cấu trúc bài toán. Từ chối bằng prompt chỉ hỏi: ngữ cảnh này có đủ để trả lời không? Nó không hỏi: ngữ cảnh này có đúng không?
Một đoạn bị làm sai vẫn 'đủ'. Nó liên quan tới câu hỏi, chứa thực thể và quan hệ cần thiết, trả lời trực tiếp. Bộ phân loại đủ hay không đủ không có tín hiệu nào để từ chối, nên nó cho qua — và mô hình sinh câu trả lời sai bằng giọng điệu chắc chắn.
Kết luận của bài rất gọn: prompt chỉ hỏi ngữ cảnh có đủ không, không hỏi có đúng không, và không bộ kiểm tra nào đóng được khoảng cách đó mà không đánh đổi giữa độ phủ và độ an toàn.
Trích dẫn cũng có thể bị bịa
Trích dẫn thường được đọc như dấu hiệu của độ tin cậy: có nguồn nghĩa là có kiểm chứng. Nhưng trích dẫn chỉ là một tuyên bố nữa mà mô hình sinh ra, và nó cũng có thể bị bịa.
Nghiên cứu của Stanford về các công cụ nghiên cứu pháp lý cho thấy đây không phải chuyện hàn lâm. Một số nhà cung cấp quảng cáo rằng RAG loại bỏ hoặc tránh được hiện tượng bịa, thậm chí bảo đảm trích dẫn pháp lý không bị bịa. Nghiên cứu kiểm chứng lại và cho thấy các công cụ vẫn tạo ra nội dung bịa.
Bài học không phải 'đừng dùng RAG'. Bài học là trích dẫn không tự động là bằng chứng: một liên kết chỉ có giá trị khi nó trỏ tới đúng nguồn, và nguồn đó thực sự chống đỡ cho câu được viết ra.
Groundedness không phải truth
Một điểm faithfulness duy nhất dễ trở thành mục tiêu tối ưu — và cũng dễ che mất lỗi. Câu trả lời có thể bám sát văn bản được truy hồi mà vẫn sai, chỉ vì văn bản đó đã cũ, thiếu, mâu thuẫn hoặc không có thẩm quyền.
Bài Groundedness Is Not Truth (ACL 2026) đặt vấn đề đúng ở đó.
Groundedness không phải là truth. Một điểm faithfulness duy nhất có thể che mất nhiều kiểu hỏng cần cách sửa khác nhau — câu trả lời có thể dựa trên văn bản đã cũ, thiếu, mâu thuẫn hoặc không có thẩm quyền.
Hệ quả trực tiếp: nếu bạn chỉ báo cáo một chỉ số groundedness, bạn biết có lỗi nhưng không biết lỗi nằm ở truy hồi hay ở sinh — và nếu không biết lỗi nằm ở đâu, bạn không sửa được.
Đo chất lượng trích dẫn: ba chiều và một con số khó chịu
ALCE là benchmark đầu tiên để đánh giá tự động trích dẫn của LLM, trên ba chiều: fluency, correctness và citation quality. Các chỉ số này tương quan mạnh với đánh giá của con người, nghĩa là bạn theo dõi được mà không cần chấm tay mọi câu.
- Fluency: câu trả lời đọc tự nhiên, không vỡ.
- Correctness: nội dung có đúng không.
- Citation quality: mỗi trích dẫn có thực sự chống đỡ cho đúng phần văn bản nó đứng cạnh không.
Con số khó chịu: trên bộ ELI5, ngay cả những mô hình tốt nhất vẫn thiếu hỗ trợ trích dẫn đầy đủ trong 50% trường hợp — tức một nửa số câu trả lời có ít nhất một phần chưa được nguồn chống đỡ đầy đủ.
Bài nêu ba hướng cải thiện, và cả ba đều là việc phải xây chứ không phải việc phải dặn: một bộ truy hồi tốt hơn, một LLM ngữ cảnh dài hơn, và khả năng tổng hợp từ nhiều nguồn.
Ngữ cảnh dài hơn không tự động sửa được (Lost in the Middle)
Hiệu năng thường cao nhất khi thông tin liên quan nằm ở đầu hoặc cuối ngữ cảnh đầu vào, và giảm rõ rệt khi phải lấy thông tin ở giữa ngữ cảnh dài. Hiện tượng này xuất hiện kể cả với các mô hình được quảng cáo là ngữ cảnh dài, trên hai tác vụ: hỏi đáp nhiều tài liệu và truy hồi khoá-giá trị.
Hệ quả cho thiết kế RAG: nếu đoạn bằng chứng đúng bị chôn ở giữa một ngữ cảnh dài, mô hình có thể bỏ qua nó — kể cả khi nó có mặt. Thêm ngữ cảnh không phải là thêm bằng chứng, và thứ tự xếp hạng trở thành một phần của độ chính xác.
Bốn thứ phải xây thay cho một lời dặn
Gộp các bằng chứng trên lại, việc phải làm không phải là viết một câu lệnh dài hơn. Đó là bốn thứ thuộc về kiến trúc, không thuộc về prompt.
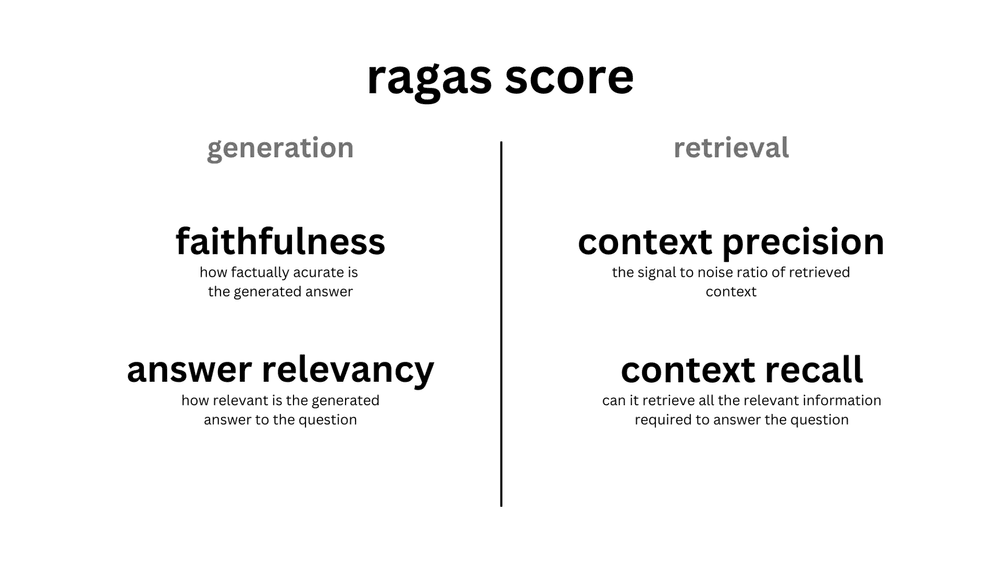
Bộ chỉ số RAG tách thành hai nhóm: chỉ số sinh và chỉ số truy hồi. Điều này quan trọng vì một điểm faithfulness đơn lẻ không cho bạn biết lỗi nằm ở khâu truy hồi hay khâu sinh — và hai lỗi đó cần hai cách sửa khác nhau.
- Truy hồi phải mang về bằng chứng có thể bị chống lại, không chỉ bằng chứng giống câu hỏi. Một tín hiệu tương đồng duy nhất không phân biệt được đoạn đúng với đoạn được viết để trông đúng.
- Nguồn gốc và thẩm quyền của bằng chứng phải được kiểm tra riêng, tách khỏi điểm giống. Văn bản cũ, thiếu hoặc không có thẩm quyền vẫn có thể 'grounded'.
- Ràng buộc trích dẫn phải nằm ở tầng cấu trúc, không chỉ ở tầng mô hình. Một marker bắt buộc là thứ pipeline kiểm được, còn một lời hứa trong prompt thì không.
- Phép đo phải tách thiếu và sai thành hai trục, và phải chạy lại được trên cùng một bộ đề để so sánh chính sách.
Thiết kế phép đo: tách thiếu và sai
Nếu bạn chỉ đo một tỉ lệ trả lời đúng, abstention trông như một sự thụt lùi: trả lời ít hơn nghĩa là điểm thấp hơn. Muốn thấy giá trị của việc từ chối, phép đo phải tách hai tình huống.
{ "trace_id": "...", "route": "normal | cache | sensitive", "context_condition": "supportive | degraded | missing | misleading", "abstained": false, "cited_sources": ["S1", "S3"]}- Chạy cùng một bộ câu hỏi dưới cả bốn điều kiện ngữ cảnh: supportive, degraded, missing, misleading.
- Tính riêng tỉ lệ từ chối khi bằng chứng thiếu và tỉ lệ từ chối khi bằng chứng sai — hai con số khác nhau về ý nghĩa.
- Đo độ phủ và độ an toàn như hai cạnh của một đánh đổi: bộ kiểm tra càng chặt, càng nhiều câu trả lời đúng bị vứt bỏ.
- Giữ mọi thứ còn lại cố định — cùng mô hình, cùng bộ đề — để thay đổi chỉ còn đúng một biến.
Cách này cho bạn một bức tranh trung thực: bạn biết cơ chế nào đang trả giá bằng độ phủ và mua lại bao nhiêu độ an toàn.
OpenVie cài đặt những điều này ở đâu
OpenVie không hứa một lời dặn nào sửa được tất cả. Các hành vi trên nằm ở những điểm cụ thể của hệ thống:
- M3 — Abstention: khi không có bằng chứng liên quan, hệ thống thông báo thiếu thông tin thay vì suy đoán.
- M2 — Trích dẫn [S1]: nguồn chỉ hiển thị sau khi Spring kiểm tra quyền truy cập và lưu phản hồi cuối; bản nháp không có link hay thẻ nguồn.
- M12 — Tuyến từ khoá nhạy cảm (Việt/Anh) bỏ qua bộ đệm câu trả lời ngữ nghĩa và yêu cầu marker nguồn. Đây là kiểm tra cấu trúc, không phải model pháp lý đã huấn luyện.
- M25 — Đánh giá ngoại tuyến chạy lại trace JSONL ẩn danh có nhãn để chấm quyết định, tuyến và trích dẫn, không gọi model.
- M4 — Truy hồi hybrid dense + sparse (BM25) + đồ thị, có viết lại câu hỏi nối tiếp và dung hợp thứ hạng RRF, cấp bằng chứng cho bước trên.
Điểm chung của các mục này là chúng nằm ở tầng cấu trúc và tầng đo lường, chứ không ở tầng câu chữ trong prompt. Một marker nguồn bắt buộc là thứ pipeline kiểm được; một lời dặn 'hãy trích dẫn' thì không.
Ranh giới: cái gì hệ thống không hứa
Cần nói rõ những gì không có, để không biến một cơ chế cấu trúc thành một lời hứa quá mức.
- Không có lời hứa 'không bao giờ bịa' hay 'chính xác tuyệt đối'. Abstention giảm một lớp lỗi, không xóa hết.
- M12 là kiểm tra cấu trúc theo marker, không phải một model pháp lý đã huấn luyện.
- Chưa có ngữ liệu luật Việt Nam, chưa có model xác minh đã huấn luyện, chưa có huấn luyện VLQA/SFT/QLoRA/DPO.
- Mã nguồn trong repo chưa phải bằng chứng của một dịch vụ production; tích hợp provider tùy chọn và gia cố triển khai phải được kiểm chứng trong môi trường của bạn.
Các cơ chế ở đây làm cho lỗi khó xảy ra hơn và dễ phát hiện hơn, chứ không biến bài toán khó thành bài toán đã giải.
Tóm lại
Từ chối trả lời là một hành vi của hệ thống, không phải một câu lệnh. Bằng chứng công khai cho thấy lời dặn xử lý được ngữ cảnh thiếu nhưng sụp đổ trước ngữ cảnh sai — nơi 41,6% câu vẫn được trả lời, và 63% trong số đó lặp lại thực thể sai.
- Tách 'thiếu' khỏi 'sai' trong cả cơ chế lẫn phép đo.
- Kiểm tra nguồn gốc và thẩm quyền của bằng chứng, không chỉ độ giống.
- Ràng buộc trích dẫn bằng cấu trúc và đánh giá lại ngoại tuyến.
- Thừa nhận đánh đổi giữa độ phủ và độ an toàn thay vì che nó.
Câu trả lời trôi chảy không phải là câu trả lời đúng. Một hệ thống tốt là hệ thống biết khi nào nên im lặng — và biết rằng im lặng chỉ là một nửa của câu chuyện.
Nguồn tham khảo
- Prompt-Based Abstention Fails Under Misleading Context (GRAB-RAG) — arXiv:2608.22228
- Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools — Stanford (PDF)
- Groundedness Is Not Truth: Evidence-Chain Forensics for RAG — ACL Anthology
- Enabling Large Language Models to Generate Text with Citations (ALCE) — arXiv:2305.14627
- Lost in the Middle: How Language Models Use Long Contexts — arXiv:2307.03172